เหตุใดจึงไม่แนะนำให้ใช้ AI Agent อย่าง Codex แปล PDF โดยตรง?
สรุปโดยย่อ
AI agent สามารถช่วยคุณอ่าน PDF ตอบคำถาม สรุปเนื้อหา อธิบายศัพท์เทคนิค รวมถึงช่วยตรวจสอบและปรับแก้ย่อหน้าสำคัญได้แต่หากคุณต้องการเอกสารแปลในรูปแบบ PDF ที่มีรูปแบบคงที่ ดาวน์โหลดได้ และส่งมอบให้เพื่อนร่วมงานหรือลูกค้าได้ การให้ agent ประมวลผลเอกสารทั้งฉบับตั้งแต่ต้นโดยตรงมักไม่ใช่ตัวเลือกที่มั่นคงที่สุด
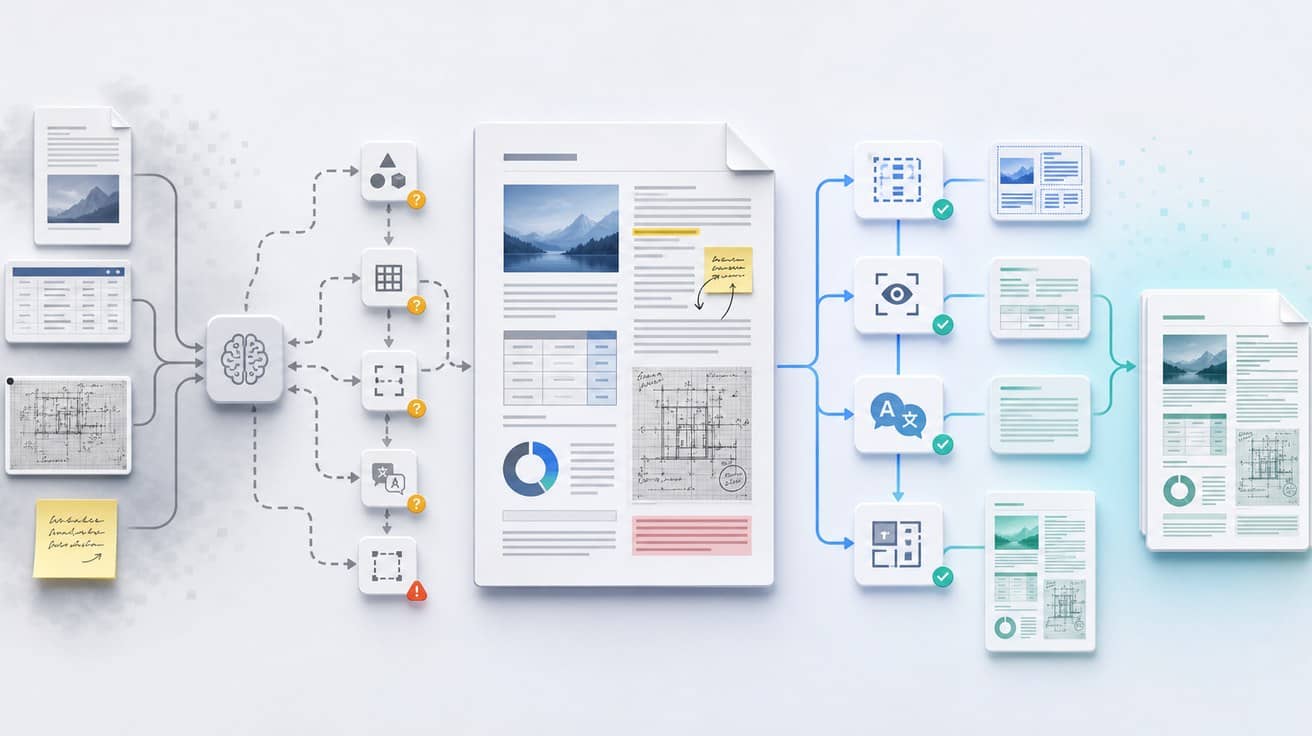
จุดท้าทายของการแปล PDF ไม่ได้อยู่แค่ความแม่นยำในการแปลเพียงอย่างเดียวโครงสร้างสองคอลัมน์ของบทความวิชาการ แผนภูมิและหมายเหตุในเอกสารทางวิศวกรรม ส่วนหัวและท้ายของ PDF เชิงธุรกิจ OCR ของเอกสารสแกน การเติมเนื้อหากลับในการ์ตูนหรือเนื้อหาที่ผสมข้อความและภาพ ล้วนต้องอาศัยระบบที่เข้าใจทั้งภาษาและโครงสร้างหน้าเอกสารไปพร้อมกัน
ดังนั้น การแบ่งหน้าที่ที่เหมาะสมกว่าคือ เมื่อต้องการทำความเข้าใจเนื้อหา ให้ใช้เครื่องมือประเภท Codex, ChatGPT Agentเมื่อต้องการส่งมอบไฟล์แปล PDF ให้ใช้เครื่องมือแปลเอกสารเฉพาะทางอย่าง Shangyi AI(商译 AI)
AI agent สามารถแปล PDF ได้หรือไม่?
ได้ แต่เหมาะสมกับการ"ช่วยทำความเข้าใจ"มากกว่า ไม่จำเป็นต้องเหมาะสมเป็น"เครื่องมือส่งมอบ PDF"
ตัวอย่างเช่น คุณสามารถให้ agent สรุปบทความวิชาการภาษาต่างประเทศได้อย่างรวดเร็ว อธิบายข้อกำหนดทางวิศวกรรมบางส่วน สกัดข้อกำหนดความเสี่ยงในสัญญา หรือตรวจสอบความเป็นธรรมชาติของข้อความแปลงานเหล่านี้มีแก่นแท้อยู่ที่การทำความเข้าใจเนื้อหาและการประเมินทางภาษา ซึ่ง agent มีความเชี่ยวชาญเป็นอย่างมาก
แต่การแปล PDF ที่สมบูรณ์ยังต้องจัดการกับรูปแบบเลย์เอาต์ข้อความใน PDF อาจไม่ได้เรียงต่อเนื่องเป็นย่อหน้า แต่กระจัดกระจายเป็นบล็อกข้อความตามพิกัดบนหน้าเอกสาร PDF ที่สแกนมาอาจไม่มีชั้นข้อความจริงเลย เป็นเพียงรูปภาพธรรมดา คำบรรยายภาพ เชิงอรรถ ตาราง เลขหน้า และลายน้ำก็อาจถูกอ่านผิดหรือเรียงลำดับสับสน
ปัญหาเหล่านี้ไม่สามารถแก้ไขได้ด้วยคำสั่งพรอมต์เพียงอย่างเดียว จำเป็นต้องอาศัยกระบวนการวิเคราะห์เลย์เอาต์เฉพาะทาง OCR การแปล การเติมข้อความกลับ และการตรวจสอบด้วยภาพ
AI agent เทียบกับเครื่องมือแปล PDF เฉพาะทาง
| มิติ | AI agent | เครื่องมือแปล PDF เฉพาะทาง |
|---|---|---|
| งานที่เหมาะสม | การอ่าน การสรุปความ การถาม-ตอบ การปรับแต่งย่อหน้าสำคัญ การตรวจทานหลังการแปล | แปลเอกสาร PDF ทั้งฉบับและส่งออกไฟล์แปลที่ดาวน์โหลดได้ |
| สถานการณ์ใช้งานทั่วไป | อ่านบทความวิจัยเฉพาะหน้า ทำความเข้าใจสัญญา อธิบายศัพท์เทคนิค ตรวจทานเนื้อหา | บทความวิชาการ เอกสารทางวิศวกรรม PDF ทางธุรกิจ เอกสารสแกน เอกสารผสมภาพและข้อความ |
| การจัดการรูปแบบเอกสาร | ต้องดึงข้อมูลชั่วคราว จับภาพหน้าจอ ใช้ OCR หรือเขียนสคริปต์ ผลลัพธ์ขึ้นอยู่กับความซับซ้อนของไฟล์ | มีกระบวนการแยกวิเคราะห์หน้ากระดาษ OCR สร้างใหม่ และตรวจสอบคุณภาพที่กำหนดไว้ |
| การเปลี่ยนแปลงของต้นทุน | เอกสารยาว การพิสูจน์อักษรหลายรอบ และการลองใหม่เมื่อล้มเหลวจะขยายต้นทุน | เหมาะสมกว่าในการประมาณการต้นทุนตามสถิติเอกสารและกระบวนการแต่ละหน้า |
| เอกสารสแกน | ต้องการ OCR เพิ่มเติมและการกรอกพิกัดกลับ เสี่ยงต่อการขาดตัวอักษรหรือผิดตำแหน่ง | มักมีระบบ OCR การระบุตำแหน่งหน้า และความสามารถในการเติมข้อความแปลกลับในตัว |
| ประสบการณ์การส่งมอบงาน | เหมาะสมกว่าในการส่งออกคำอธิบายและข้อเสนอแนะการตรวจสอบ | เหมาะสมกว่าในการแสดงตัวอย่าง ดาวน์โหลด แชร์ และตรวจสอบในขั้นตอนถัดไป |
เหตุใดการแปล PDF จึงไม่เหมือนการแปลข้อความธรรมดา?
เป้าหมายการออกแบบของ PDF คือการทำให้เอกสารแสดงผลเหมือนกันในทุกอุปกรณ์ ไม่ใช่การทำให้เนื้อหาแก้ไขได้ง่ายดังนั้น การแปล PDF มักต้องจัดการกับข้อความ พิกัดหน้ากระดาษ รูปภาพ ฟอนต์ ตาราง และลำดับการอ่านไปพร้อมกัน
PDF ที่ดูธรรมดาสามัญ อาจมีปัญหาแฝงอยู่มากมาย:
- บทความสองคอลัมน์ต้องระบุว่าควรอ่านคอลัมน์ซ้ายหรือขวาก่อน
- แบบวิศวกรรมและเอกสารทางเทคนิคมีคำอธิบายภาพประกอบ หมายเลขอ้างอิง ตาราง และหน่วยวัดจำนวนมาก
- ส่วนหัวและส่วนท้ายของเอกสารธุรกิจ ตราประทับ และลายน้ำไม่จำเป็นต้องแปลทั้งหมด
- เอกสารสแกนจำเป็นต้องผ่าน OCR และผลลัพธ์จาก OCR ต้องถูกจัดวางกลับไปยังตำแหน่งเดิมในหน้าเอกสาร
- การ์ตูน โบรชัวร์ และเอกสารที่มีการผสมผสานข้อความกับรูปภาพ จำเป็นต้องจัดการกับปัญหาข้อความที่ถูกบดบังและการจัดเค้าโครงย้อนกลับ
นี่คือเหตุผลที่การแปล PDF มีลักษณะเป็นงานผสมผสานของ 'การทำความเข้าใจเอกสาร + การแปล + การสร้างเค้าโครงใหม่'agent สามารถช่วยเสริมในส่วนของการระบุภาษา แต่เครื่องมือเฉพาะทางเหมาะสมกว่าในการรับผิดชอบการประมวลผลเอกสารทั้งฉบับอย่างมีเสถียรภาพ
หากคุณให้ความสำคัญกับการรักษารูปแบบหลังการแปล PDF สามารถอ้างอิงจาก กลยุทธ์การแปลเอกสาร PDF ของ 商译 AIหากจัดการกับเอกสารทางวิศวกรรมหรือทางเทคนิค สามารถดูเพิ่มเติมได้ที่การวิเคราะห์ความท้าทายในการแปลเอกสารทางเทคนิค
PDF ขนาดยาวทำให้ต้นทุนของ agent ขาดเสถียรภาพ
หลายคนมักเข้าใจว่า: เมื่อจำนวนหน้า PDF เพิ่มเป็นสองเท่า ต้นทุน agent ก็จะเพิ่มเป็นสองเท่าเช่นกัน การประมาณการนี้ถือได้ว่าใช้ได้โดยทั่วไปกับไฟล์สั้นหรือสถานการณ์ที่เป็นข้อความล้วน แต่ PDF ขนาดยาว เอกสารสแกน และรูปแบบที่ซับซ้อนมักไม่เป็นเช่นนั้น
เพื่อรับประกันความสอดคล้องของบริบท agent อาจต้องนำศัพท์เฉพาะ สรุปเนื้อหาก่อนหน้า ย่อหน้าที่แปลแล้ว ภาพหน้าจอของเพจ ผลลัพธ์ OCR และความเห็นการพิสูจน์อักษรไปด้วยซ้ำๆ ทุกครั้งที่เพิ่มรอบการตรวจสอบ จะเพิ่มข้อมูลนำเข้าและการเรียกใช้เครื่องมือใหม่
PDF ที่ซับซ้อนมักต้องผ่านกระบวนการแก้ไขหลายรอบ:
- สกัดข้อความและองค์ประกอบหน้าเอกสาร
- กำหนดลำดับการอ่าน
- แปลเนื้อหาหลัก ตาราง และคำอธิบายภาพประกอบ
- ตรวจสอบความสอดคล้องของศัพท์ทางเทคนิค
- แก้ไขข้อผิดพลาดจาก OCR
- พยายามฟื้นฟูรูปแบบเค้าโครง
- พบปัญหาข้อความล้น การบดบัง หรือส่วนที่แปลไม่ครบ แล้วต้องทำใหม่
ดังนั้นสำหรับเอกสารวิชาการหลายสิบหน้า เอกสารทางวิศวกรรมหลายร้อยหน้า หรือเอกสารสแกนจำนวนมาก ต้นทุนอาจเปลี่ยนจากเกือบเชิงเส้นตรงไปเป็นเชิงเส้นเกินสิ่งที่สิ้นเปลืองจริงๆ ไม่ใช่การแปลแต่ละส่วน แต่เป็นการอ่านซ้ำ การลองใหม่เมื่อล้มเหลว และการตรวจสอบด้วยตนเอง
ควรใช้ agent เมื่อใด?
เมื่อคุณต้องการเพียงแค่ทำความเข้าใจ PDF อย่างรวดเร็ว agent ก็เหมาะสมอยู่แล้ว
การใช้งานทั่วไปได้แก่:
- สรุปประเด็นการวิจัย วิธีการ และข้อสรุปของบทความวิชาการภาษาต่างประเทศ
- อธิบายส่วนสำคัญในมาตรฐานทางวิศวกรรมหรือคู่มือทางเทคนิค
- สกัดจุดเสี่ยงจากสัญญาหรือเอกสารทางธุรกิจ
- สร้างร่างศัพท์เฉพาะเพื่ออำนวยความสะดวกในการกำหนดคำแปลที่สอดคล้องกันในภายหลัง
- เปรียบเทียบต้นฉบับกับคำแปล เพื่อค้นหาข้อผิดพลาดที่อาจเกิดขึ้น
- ปรับปรุงภาษาจีนหรือปรับรูปแบบสำหรับย่อหน้าที่สำคัญ
กล่าวคือ agent เปรียบเสมือนผู้ช่วยวิเคราะห์ที่พร้อมให้บริการตลอดเวลา เหมาะสำหรับช่วยให้คุณ "เข้าใจ" และ "ตัดสิน"
ควรใช้ Shangyi AI (商译 AI) เมื่อใด?
หากเป้าหมายของคุณคือการได้รับไฟล์คำแปลที่สามารถบันทึก แชร์ ตรวจสอบ หรือส่งมอบได้ จะเหมาะสมกว่าที่จะใช้เครื่องมือเฉพาะทางอย่าง Shangyi AI
โดยเฉพาะอย่างยิ่งในสถานการณ์ดังต่อไปนี้:
- บทความทางวิชาการ รายงานการวิจัย ไวท์เปเปอร์ในอุตสาหกรรม
- เอกสารทางวิศวกรรมและเทคนิค คู่มือผลิตภัณฑ์ เอกสารประกวดราคา
- ไฟล์ PDF ที่สแกนหรือไฟล์รูปแบบภาพ
- ไฟล์ PDF ที่มีความซับซ้อนประกอบด้วยตาราง คำอธิบายภาพ เชิงอรรถ สองคอลัมน์ หลายคอลัมน์
- ทีมเดียวกันต้องจัดการไฟล์การแปลหลายประเภท เช่น การ์ตูน คำบรรยายซีรีส์สั้น และต้องการให้กระบวนการทำงานเป็นมาตรฐานเดียวกัน
- ต้องการดูตัวอย่างผลการแปลก่อน จึงตัดสินใจว่าจะดำเนินการแปลฉบับเต็มหรือไม่
- ต้องการความสอดคล้องของศัพท์เทคนิค ไม่สามารถให้คำเดียวกันมีคำแปลหลายแบบภายในเอกสารเดียวได้
- ต้องการให้สมาชิกในทีมหรือลูกค้าเข้าถึงและตรวจสอบไฟล์ PDF ที่แปลแล้วได้โดยตรง
ฟีเจอร์แสดงตัวอย่างการแปลของ Shangyi AI เหมาะสำหรับการตรวจสอบคุณภาพและรูปแบบก่อนดำเนินการแปลอย่างเป็นทางการ; หากคุณต้องจัดการกับศัพท์เทคนิคเฉพาะอุตสาหกรรมเป็นประจำ สามารถศึกษาเพิ่มเติมได้จากคู่มือศัพท์ศัพท์ Shangyi AIหากเอกสารของคุณเป็นการ์ตูนหรือเนื้อหาที่มีการผสมผสานภาพและข้อความ สามารถศึกษาเพิ่มเติมเกี่ยวกับปัญหาการวาดใหม่และการจัดวางในการแปลการ์ตูน
FAQ
ต้นทุนการแปล PDF ด้วย AI agent เพิ่มขึ้นแบบเชิงเส้นหรือไม่?
ไม่จำเป็น PDF ขนาดสั้นหรือไฟล์ที่มีชั้นข้อความชัดเจนมักจะมีการเพิ่มขึ้นใกล้เคียงแบบเชิงเส้น; เอกสาร PDF ที่มีความยาวมาก เอกสารสแกน ตารางที่ซับซ้อน เนื้อหาแบบผสมผสานข้อความและรูปภาพ และการตรวจทานหลายรอบ จะทำให้ต้นทุนเพิ่มขึ้นแบบไม่เป็นสัดส่วนสาเหตุหลักมาจากบริบทที่ซ้ำซ้อน OCR การเรียกใช้เครื่องมือ การกรอกข้อมูลย้อนกลับสู่รูปแบบเดิม และการลองใหม่เมื่อล้มเหลว
เหตุใดรูปแบบ PDF จึงยากต่อการคืนค่าเดิม?
เนื่องจาก PDF มุ่งเน้นที่ผลลัพธ์การแสดงผลหน้าเอกสาร ไม่ใช่โครงสร้างข้อความที่สามารถแก้ไขได้ หลังจากการแปลความยาวของข้อความจะเปลี่ยนแปลงไป กล่องข้อความเดิมอาจจุไม่ได้ตาราง รูปภาพ เชิงอรรถ ส่วนหัวและส่วนท้าย และลำดับการอ่านแบบหลายคอลัมน์ ก็ต้องมีการตัดสินและตรวจสอบความถูกต้องใหม่
Codex หรือ ChatGPT Agent ไม่สามารถใช้สำหรับการแปล PDF ได้เลยหรือ?
ไม่ใช่เช่นนั้นพวกมันเหมาะสำหรับการทำความเข้าใจเอกสาร อธิบายย่อหน้า สกัดศัพท์เทคนิค สรุปประเด็นสำคัญ และช่วยเหลือในการตรวจทานเพียงแต่เมื่อเป้าหมายคือการส่งออกผลงานแปลเป็น PDF ที่มีความเที่ยงตรงสูงทั้งฉบับ เครื่องมือแปล PDF เฉพาะทางมักมีความเสถียรมากกว่า
ทำไม PDF ที่สแกนจึงทำงานได้ยากกว่า?
PDF ที่สแกนนั้นโดยแก่นแท้แล้วคือไฟล์ภาพระบบจำเป็นต้องใช้ OCR จดจำข้อความก่อน จากนั้นระบุตำแหน่งพิกัดบนหน้าเอกสาร และจัดการกับปัญหาความเอียง ความเบลอ สิ่งรบกวนจากพื้นหลัง คำอธิบายประกอบที่เขียนด้วยมือ และการบดบังของภาพ หากเกิดข้อผิดพลาดในขั้นตอนการจดจำหรือการเติมข้อความกลับขั้นตอนใดขั้นตอนหนึ่ง ก็จะส่งผลกระทบต่อคุณภาพของผลงานแปลขั้นสุดท้าย
ขั้นตอนการทำงานที่แนะนำคืออะไร?
แนวทางที่มั่นคงกว่าคือ ใช้เครื่องมือแปล PDF เฉพาะทางสร้างไฟล์แปลที่สามารถดูตัวอย่างและดาวน์โหลดได้ก่อน จากนั้นจึงใช้ AI agent ตรวจทานย่อหน้าสำคัญ คำศัพท์ และสำนวนเฉพาะทางอีกครั้ง วิธีนี้จะช่วยให้ได้ทั้งการส่งมอบเอกสารที่มีรูปแบบครบถ้วนและการตรวจสอบภาษาอย่างละเอียด
บทสรุป
AI agent เหมาะสมอย่างยิ่งในการทำหน้าที่เป็นผู้ช่วยอ่าน PDF แต่ไม่จำเป็นว่าจะเหมาะสมในการเป็นระบบแปลและส่งมอบเอกสาร PDF ฉบับสมบูรณ์ความท้าทายที่แท้จริงของการแปล PDF คือการที่ปัญหาด้านภาษา OCR เค้าโครงหน้ากระดาษ ลำดับการอ่าน และการตรวจสอบภาพรวมทับซ้อนกัน
เมื่อต้องการทำความเข้าใจเนื้อหาอย่างรวดเร็ว สามารถใช้ agent ได้เมื่อต้องการส่งมอบเอกสาร PDF ที่แปลแล้ว แนะนำให้ใช้ Shangyi AI(商译 AI) 文档翻译 โดยดูตัวอย่างก่อน แล้วจึงดำเนินการแปลฉบับเต็ม